
大家好,我是Zack。
先说一个场景:你想让 AI 做个页面,憋了半天打出一行需求——「做一个现代简约风格的看板,要好看,要有数据统计,布局清晰一点」。
它给你做出来了。打开一看,不是你想的那个东西。
你说「简约」,它理解的简约和你想的差了十万八千里。你再打字解释,它再改,三轮下来一小时没了,你俩还在互相猜。
我以前也这样,直到我把「打字描述」换成了「丢截图」。同一个需求我掐表测过:纯文字描述跑 118 秒,出来的东西一半不是我说的;丢一张截图加一句话,63 秒完事,一轮到位。今天把这套做法拆给你,命令全部可抄。
纯文字到底差在哪
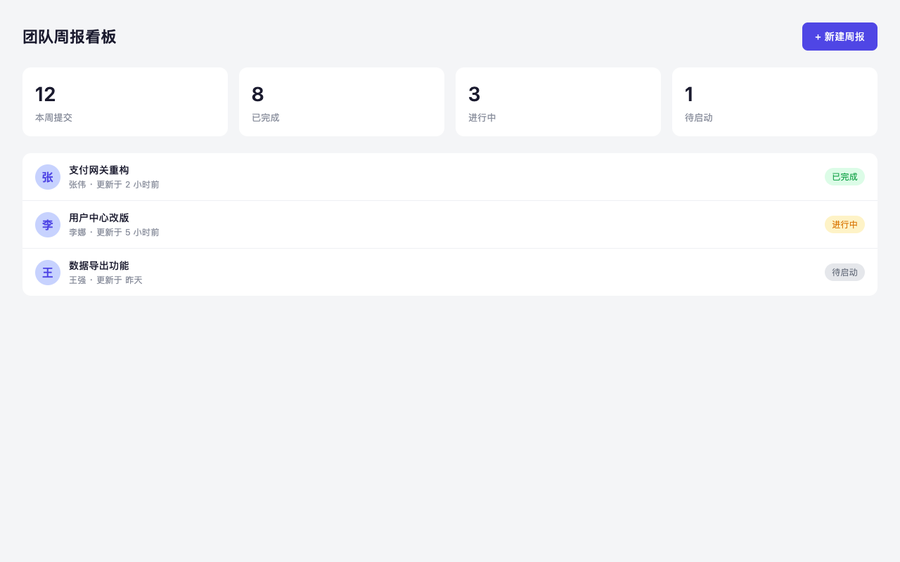
我拿真实实验说话。先造了个参考页面:一个团队周报看板,顶上标题加按钮,中间四张数据卡片,下面一个任务列表,每行头像加状态徽章。截图存成 reference.png。
然后我在一个空目录里,用同一句话开跑:
claude -p "帮我做一个团队周报看板的网页,单个html文件就行。要能看到本周提交数、完成情况,还有一个列表显示每个人负责什么、什么状态。做得好看点,现代风格。"
118 秒跑完。打开页面,三处跑偏:
第一,数字是我没要的。它自己编了 79 次提交、四个人名、一堆进度条。我要的是「看到数据」,没让它编数据。
第二,凭空多了一个每日提交堆叠柱状图,还带图例、hover 提示。功能是挺花哨,但我一个字没提。
第三,「现代风格」它理解成了它自己的版本——配色、间距、卡片圆角,全按它的审美来。
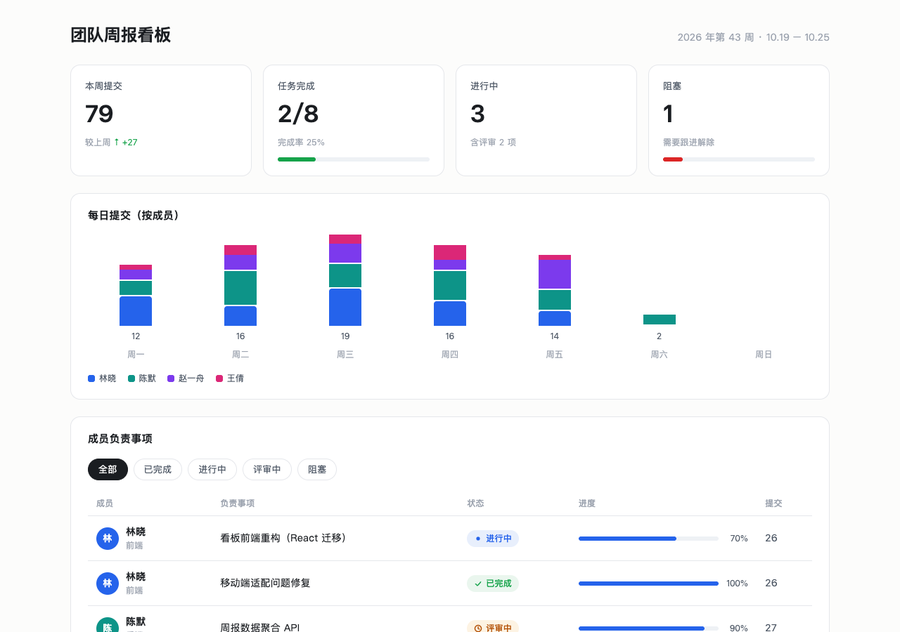
这些跑偏不能全怪 AI。「好看」「现代」「布局清晰」这类词,每个人脑子里对应的东西都不一样。你打字打得再细,也是在用文字翻译脑子里那张图,翻译就要丢信息。
换成截图,一句话够了
同一个空目录,第二回我只给了它一张图加一句话:
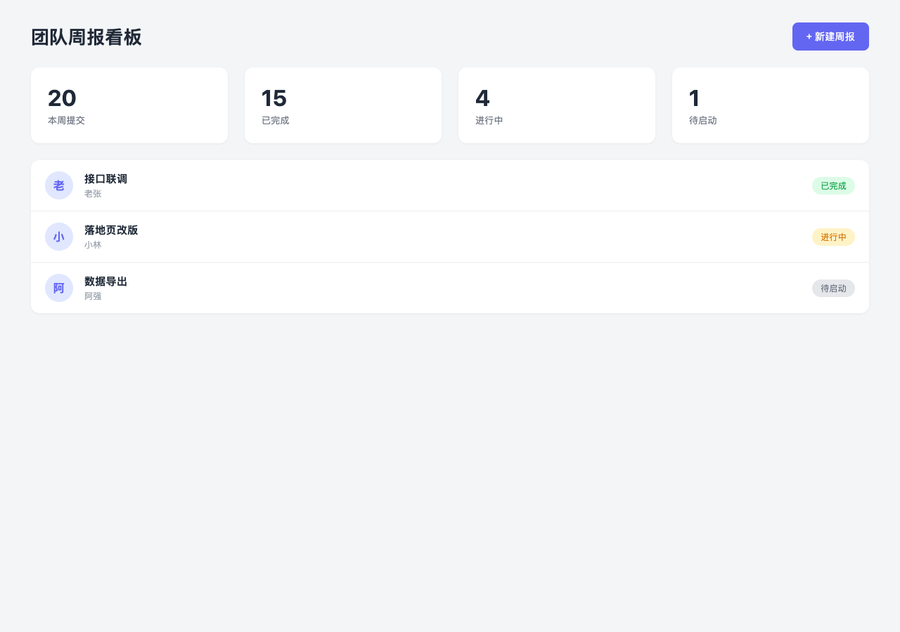
claude -p "参考截图 /tmp/shot_demo/reference.png 的布局做一个网页,单个html文件。数据换成我的:本周提交 20、已完成 15、进行中 4、待启动 1。列表换成:接口联调-老张-已完成,落地页改版-小林-进行中,数据导出-阿强-待启动。"
63 秒跑完。四张卡片、任务列表、头像、彩色状态徽章,全对上了。数据是我给的数,一个没编。耗时少了一半,因为不用猜,力气全花在写代码上。
前后对比放一张表:
| 项目 | 纯文字描述 | 截图 + 一句话 |
|---|---|---|
| 同一个需求耗时 | 118 秒 | 63 秒 |
| 产出对不对 | 编了数据、多了柱状图 | 布局照图,数据全对 |
| 你要打多少字 | 50 多字还说不清 | 40 字,布局一个字不说 |
| 返工 | 大概率改两三轮 | 我这轮一轮过 |
省掉的不是那 55 秒,是后面两三轮「不是这个意思,改一下」的拉扯。那才是真正吃时间的地方。
把我的提示词模板直接抄走
参考截图 <图片路径或直接粘贴> 的布局做一个网页,单个html文件。
布局、配色、间距都照图,不要自由发挥。
数据换成我的:<数据1、数据2、数据3>。
交互只做这两个:<点击xx后xx>、<筛选xx>。
不要引入外部框架和字体。
五行各管一件事:第一行指定图,第二行锁死布局不许它发挥,第三行给真实数据,第四行只说你要的交互,第五行防它好心给你装一堆依赖。我第二回实验就是按这个骨架写的,所以一轮过。
手机上一样能用
不在电脑前也行。刷到别人家的 App 界面好看,手机截屏,打开 Claude 或 ChatGPT 的对话框,图一贴,打一句「照这个布局帮我做个网页,数据回头再填」。手机端粘贴图片最省事,长按输入框就有粘贴选项,什么都不用学。
图多的时候怎么给
参考多个页面的话,别一次性甩五张图让它猜关系。一张图配一句话,做完第一屏,再给第二屏的图说「接着做这个页面,风格跟上面一致」。AI 跟人一样,一次吃一口消化得好,一口闷十张图它就开始自由组合。
三个实操细节
第一,图从哪来。看到别人家产品好看,截图;设计稿,截图;手画在纸上的草图,拍照。都不用管什么格式,png、jpg 都行。
第二,图之外的话只说两样:布局不用提(图里有),要说的是数据和交互。我的写法就一种句式——「数据换成我的:A、B、C」。
第三,最容易踩的坑:AI 收不到你说「这张截图」。我第一轮就栽了——命令里写「照这张截图」,它回我「我没有收到截图」。工具收图分两种方式:网页对话框里直接粘贴或拖进去;命令行 claude -p 里要说文件路径,让它自己去读。你说「这张图」它只会当你发过图了,实际什么都没拿到。
哪些场景能用
不止做网页。复刻一个 App 的界面、照着设计稿切页面、给现有页面提改版意见(甩图加一句「照这个风格改我的」),都是同一个逻辑:图负责「长什么样」,你只补「数据是什么」。
它的边界也说清楚:截图管布局和样式,管不了逻辑。接口怎么调、数据从哪来、点击之后干什么,这些还是得文字写清。图管形,字管行为,两样都给,一轮过的概率最大。
另一个局限:复杂交互的细节藏在图后面。图上看出「有个筛选按钮」,看不出「点了筛选之后列表怎么动」。这种你补一句规则就行,别指望它从静态图里悟。
通用原则就两条
一,能用图传的信息别用文字。「长什么样」属于眼睛,不属于键盘。你描述三行不如它看图三秒,还不会翻译失真。
二,需求里删掉所有形容词。「好看」「现代」「高级」都是开关,你打开的是你脑里的版本,它打开的是它脑里的版本。换成图,或者换成可验证的具体说法(四张卡片、每行带状态徽章),猜的成分就没了。
下次说不清「我想要的样子」,别打字了,截个图丢过去。
你有没有被 AI 做出来的东西「惊到过」?评论区聊聊,看看谁的最离谱。